L'IA dans vos propres applications
Au-delà du panneau de la console, un propriétaire ou administrateur d'organisation peut rattacher l'IA à une application déployée — comme on rattache une base de données : on rattache, et les variables d'environnement apparaissent dans l'application.
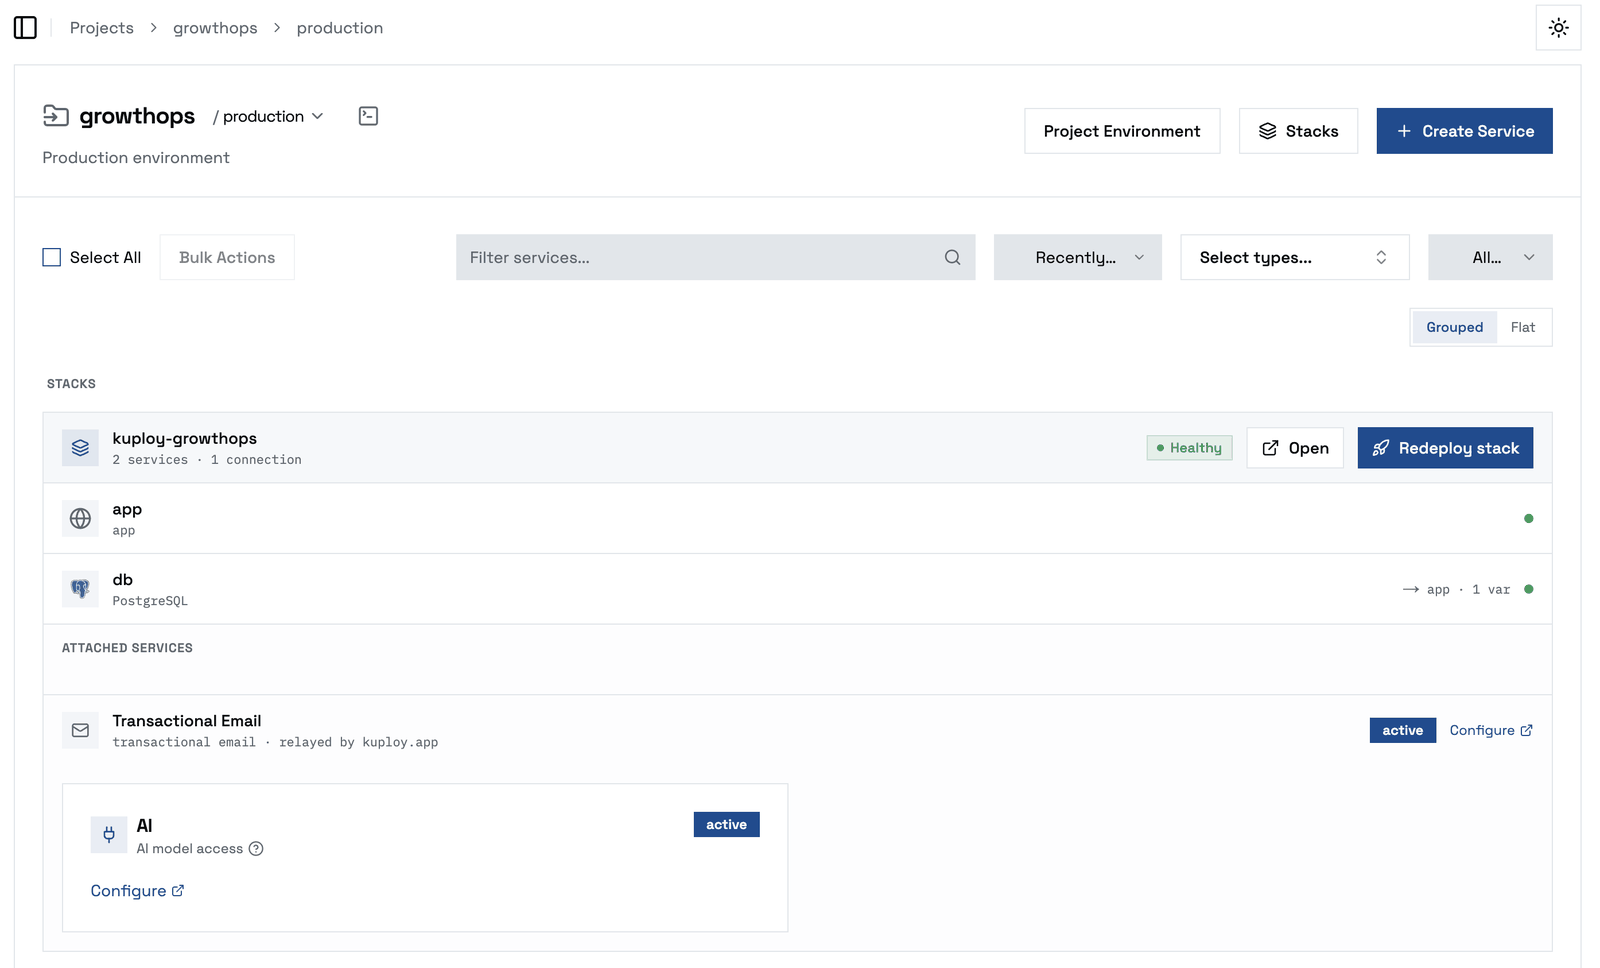
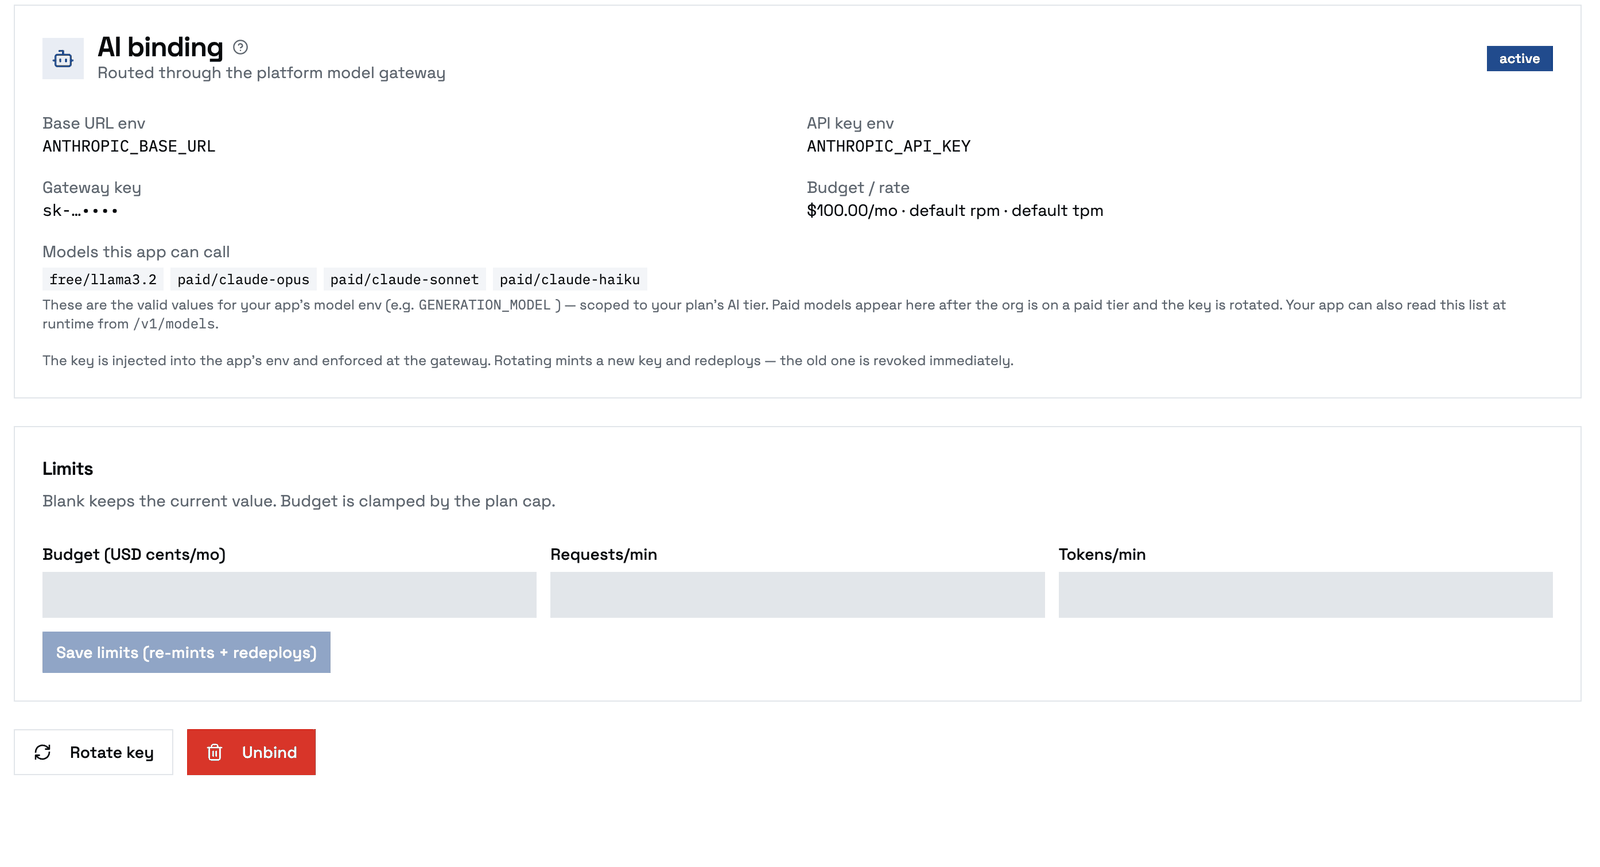
Comment rattacher : ouvrez l'environnement de l'application dans la console, faites Create Service → AI Model Access, désignez l'application et un préréglage de SDK, puis confirmez. Le rattachement est créé pour cette application — vous n'avez jamais d'identifiant d'application à saisir — les variables sont injectées et l'application est redéployée. Vous la gérez ensuite depuis sa carte, parmi les services de l'environnement : Rotate key, ajustement du budget et des limites de débit, ou Unbind.
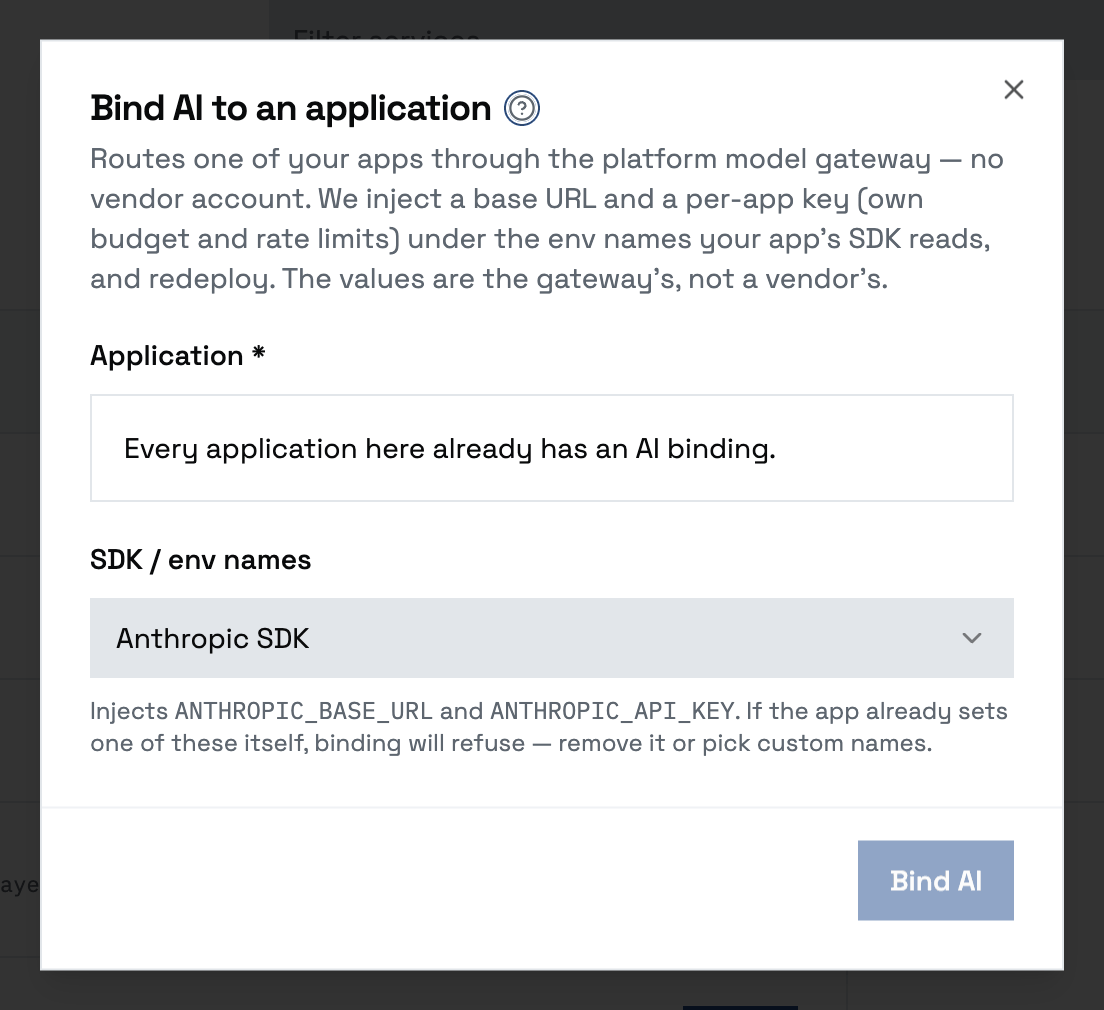
Le rattachement écrit deux variables d'environnement dans l'application et la redéploie. Vous choisissez le préréglage qui correspond au SDK de votre application — la passerelle parle les deux grands dialectes :
| Votre application utilise | Rattachez avec |
|---|---|
| Le SDK Anthropic | ANTHROPIC_BASE_URL + ANTHROPIC_API_KEY |
| Le SDK OpenAI | OPENAI_BASE_URL + OPENAI_API_KEY |
| Autre chose | Les noms de variables que votre code lit pour l'URL de base et la clé |
Ne vous laissez pas tromper par ces noms aux couleurs d'un fournisseur : les valeurs ne correspondent pas à un compte chez lui. L'URL pointe vers la passerelle de modèles de la plateforme, et la clé est une clé de passerelle propre à cette application, avec son budget mensuel et ses limites de débit. Le SDK de votre application dialogue avec la passerelle sans la moindre modification de code.
Qui fournit quoi, et qui paie :
| Couche | Fournie par | Payée par |
|---|---|---|
| Les deux variables d'environnement | La plateforme, au moment du rattachement | — |
| Les modèles du niveau gratuit | L'inférence intégrée à la plateforme | L'exploitant (le calcul) |
| Les modèles premium | Le compte fournisseur de l'exploitant, derrière la passerelle | L'exploitant paie le fournisseur ; vous payez via votre offre |
| La consommation de votre application | — | Encadrée par le budget et les limites de l'application, et par le plafond de votre offre |
Si votre application renseigne déjà sa propre clé de fournisseur sous ces noms — la variante « à la main » : votre clé, votre facture, la plateforme hors du circuit — le rattachement refuse plutôt que d'écraser : retirez d'abord la clé manuelle, ou rattachez sous d'autres noms de variables. Renouveler la clé d'un rattachement invalide immédiatement l'ancienne et redéploie l'application — à utiliser en cas de fuite, et non pour répercuter un changement d'offre, qui s'applique tout seul ; détacher révoque la clé et retire les variables.
Votre application ne détient jamais de clé de fournisseur : elle parle à la passerelle, et la passerelle applique le budget du rattachement et le plafond de votre offre.
Choisir le modèle que votre application appelle
Le rattachement n'injecte que l'URL de base et la clé — il ne décide pas du modèle que votre application demande. Cela relève de sa propre configuration, car la plateforme ne peut connaître ni la variable que votre code lit pour cela (une application l'appelle GENERATION_MODEL, une autre MODEL, une autre AI_MODEL), ni le modèle que vous voulez. Après le rattachement, définissez donc vous-même cette variable dans l'onglet Environment de l'application, puis redéployez.
Deux règles pour la valeur :
- Utilisez un nom de modèle de la passerelle, pas celui d'un fournisseur. La clé est limitée aux groupes de modèles de la plateforme : demandez par exemple
free/llama3.2oupaid/claude-opus, et non un identifiant de fournisseur commeclaude-opus-5— la passerelle rejette les noms qu'elle ne connaît pas. - Les noms autorisés dépendent du niveau d'IA de votre offre et des fournisseurs qu'elle comprend. Le niveau gratuit propose toujours
free/*; les modèlespaid/*ne sont accessibles que si votre offre est sur le niveau payant, et si l'exploitant a configuré le fournisseur correspondant. Une offre peut aussi se limiter à certains fournisseurs — Groq seulement, ou Claude seulement — auquel cas seuls ces nomspaid/*apparaissent pour vos clés. Un nom hors de votre offre est refusé même si le modèle existe : consultez votre offre, ou demandez à votre exploitant. Lorsque le niveau de votre offre change, les modèles appelables par votre clé — et par chaque rattachement — sont mis à jour tout seuls en quelques minutes : inutile de renouveler la clé, de rattacher à nouveau ou de redéployer. Réinterrogez/v1/modelspour voir la nouvelle liste.
Pour un test rapide, free/llama3.2 fonctionne sur toute offre comprenant l'assistant IA.
Découvrir ce que vous pouvez appeler, depuis votre code. Rien ne vous oblige à coder la liste en dur : votre application peut interroger le point d'accès standard des modèles avec la clé injectée et obtenir exactement les modèles autorisés pour ce rattachement, selon le niveau de votre offre. Par exemple GET $ANTHROPIC_BASE_URL/v1/models — ou models.list() avec le SDK — les renvoie : choisissez-en un pour GENERATION_MODEL à l'exécution, ou simplement pour vérifier votre niveau.
Quel modèle pour quel travail
Chaque nom de modèle correspond à une classe de taille et de rapidité. Prenez le plus petit qui fasse l'affaire : plus petit veut dire plus rapide et moins cher, et sur des tâches étroites il fait souvent tout aussi bien. (Les noms exacts dépendent de ce que votre exploitant a activé ; interrogez /v1/models pour connaître votre liste.)
| Modèle | Classe | Ce qu'il fait bien, concrètement | Exemple |
|---|---|---|---|
free/llama3.2 | Minuscule, gratuit, local | Tests de bon fonctionnement, rédaction courte et simple, classification de base. Le niveau gratuit tourne sur processeur : attendez-vous à des réponses plus lentes et à une connaissance plus fragile. | « Rédige un texte de remplacement pour cette référence produit. » |
paid/claude-haiku | Petit, rapide, économique | Extraction en grand volume, classification, détection d'intention, sorties structurées propres, premiers jets. Le cheval de trait des fonctionnalités très sollicitées. | « Extrais {nom, email, offre_visée} de ce message entrant. » · « Cet avis est-il positif, neutre ou négatif ? » |
paid/claude-sonnet | Intermédiaire, équilibré | La plupart des fonctionnalités qui demandent un vrai raisonnement et une bonne plume — résumés, réponses au support, génération de contenu à partir d'un contexte. | « Rédige une réponse au support à partir de ce ticket et de ces deux extraits de base de connaissances. » |
paid/claude-opus | Haut de gamme, plus lent, le plus cher | Raisonnement complexe en plusieurs étapes, agents élaborés, travaux ambigus ou à fort enjeu, où la qualité prime sur le coût. | « À partir de ce contrat de 40 pages, liste les clauses de résiliation et leurs risques. » |
paid/gpt | Intermédiaire (OpenAI) | Une solution générale, quand vous voulez précisément un modèle GPT. | « Reformule ce paragraphe sur un ton plus chaleureux. » |
paid/groq-llama-70b | Rapide, poids ouverts | Tâches sensibles à la latence ou au coût qui demandent tout de même un modèle capable ; bon pour les boucles d'appel d'outils. | « Oriente cette requête vers le bon traitement, avec une étiquette d'un seul mot. » |
En règle générale : haiku pour le volume, sonnet pour la plupart des fonctionnalités, opus pour les 5 % difficiles. Commencez par haiku et montez seulement si la qualité ne suit pas — jamais l'inverse.
Mise en cache des invites (modèles Claude payants) — une optimisation, que vous pouvez ignorer en première lecture
Mise en cache des invites
Si votre application envoie le même long préfixe à chaque requête — une invite système volumineuse, un bloc d'instructions, des définitions d'outils, ou une conversation qui s'allonge — marquez-le avec la mise en cache d'invites d'Anthropic : la passerelle de la plateforme le transmet tel quel au modèle. Une lecture de cache est facturée environ 10 % du tarif d'entrée normal : un préfixe stable réutilisé d'un appel à l'autre réduit donc fortement la facture.
Un préfixe stable, c'est la partie de votre requête qui ne change jamais : l'invite système, les définitions d'outils, une longue consigne permanente ou un document de référence. Marquez-en la fin par un point de césure de cache, et placez ce qui varie — le message de l'utilisateur — après ce point.
- Votre message
systemest mis en cache pour vous. Sur chaque modèlepaid/claude-*, la passerelle marque automatiquement le messagesystemde la requête comme point de césure. Anthropic met en cache tout ce qui précède un tel point, et les définitions d'outils viennent avant le bloc système : une invite système stable et vos définitions d'outils bénéficient donc de lectures de cache sans la moindre ligne de code. Il en va de même pour l'Org Agent, dont l'invite système et les définitions d'outils se répètent à chaque tour d'une boucle d'appel d'outils. - Tout ce qui se trouve dans la conversation elle-même — un long document de référence dans un tour utilisateur, un historique qui s'allonge — relève d'un choix par requête, que vous faites dans votre code : placez
"cache_control": {"type": "ephemeral"}sur le dernier bloc de contenu à mettre en cache. (Avec le SDK Anthropic : un champcache_controlsur le bloc ; le dialecte OpenAI l'accepte de même sur le contenu d'un message.) Anthropic autorise au plus quatre points de césure par requête, et celui du bloc système en consomme un. - Un bémol sur le point de césure automatique : une écriture de cache coûte environ 1,25 fois une entrée normale. Une longue invite système envoyée une seule fois, sans réutilisation dans les cinq minutes, paie donc un petit surcoût au lieu d'économiser. Réutilisez-la ne serait-ce qu'une fois et elle est rentabilisée (voir l'exemple ci-dessous).
- Cela ne vaut que pour les modèles Claude payants, avec un préfixe stable suffisamment long : environ 1 000 jetons et plus pour Sonnet et Opus, davantage pour Haiku — quelques milliers de jetons constituent un seuil sûr. En deçà, rien n'est mis en cache et vous êtes facturé normalement.
free/llama3.2ignore ce mécanisme.
Comment vous êtes facturé — chaque requête répartit son entrée en trois postes tarifés séparément :
| Poste | De quoi il s'agit | Prix par rapport à une entrée normale |
|---|---|---|
| Écriture de cache | Le préfixe, la première fois qu'il est vu | ≈ 1,25× (surcoût unique) |
| Lecture de cache | Le même préfixe, à chaque appel suivant | ≈ 0,10× |
| Entrée normale | Tout ce qui suit le point de césure (le message de l'utilisateur) | 1× |
Un gros préfixe coûte donc un peu plus une fois, puis le dixième de son prix à chaque répétition — tandis que votre entrée variable est toujours facturée normalement.
Exemple chiffré — un préfixe système de 16 800 jetons sur Sonnet, l'entrée étant à 3 $ le million de jetons :
| Sans mise en cache | Avec mise en cache | |
|---|---|---|
| 1er appel | 0,050 $ | 0,063 $ (écriture) |
| Chaque appel suivant | 0,050 $ | 0,005 $ (lecture) |
| Total sur 10 appels | 0,50 $ | 0,11 $ |
Soit environ 78 % d'économie sur 10 appels, et c'est rentabilisé dès le deuxième. Plus vous réutilisez le préfixe, plus l'économie approche les 90 %.
Le décompte reste exact : la passerelle enregistre les jetons de lecture et d'écriture de cache à ces tarifs, de sorte que la dépense imputée à votre offre reflète l'économie automatiquement, sans rien à faire.